
给记忆加上“线索”——ReMe Memory Tags
一个真正长期使用的记忆系统,迟早会遇到一个看似简单的问题:记忆越来越多以后,怎么只在“正确的那一堆”里找答案?
假设你和 Agent 先后聊过三个项目,都讨论过“发布”“预算”和“负责人”。半年后,你问:
“发布前还有什么要确认?”
这句话本身没有错,但线索太少。关键词搜索可能找回所有出现过“发布”的文档,语义搜索也可能把几个相似项目的经验混在一起。它们找到了“内容相似”的记忆,却不一定知道你此刻说的是哪个项目、哪家公司,或者哪个人。
人类回忆往往不是这样发生的。我们很少在脑海里对所有经历做一次全文搜索,而是先抓住几个线索:**关于 Alice 的、关于 Project A 的、去年讨论过的那件事。**范围缩小以后,具体细节才逐渐浮现。
这就是 ReMe 增加 Memory Tags 的原因:让每份 Markdown 记忆除了“写了什么”,还可以明确表达“这份记忆主要关于谁或什么”,并让这个线索真正参与检索。
为什么需要 Tags?
ReMe 已经可以通过 BM25 找关键词,通过可选的 Embedding 找语义相近的内容,也可以沿着 Wikilink 查看记忆之间的关系。Memory Tags 并不是要替代它们,而是补上另一个维度:检索范围。
可以把三者想成三个不同的问题:
- 搜索词回答“我现在想找什么”;
- Wikilink 回答“这份记忆和哪些记忆有关”;
- Memory Tags 回答“我应该先去哪些记忆里找”。
例如,“预算超支怎么处理”可能在很多项目里都出现过。如果搜索时加上 Project_A,Agent 就可以先把范围缩小到与 Project A 有关的文件,再在其中寻找“预算超支”的具体内容。
目录不能完全解决这个问题。一份会议记录可能同时关于 Alice、Project A 和某个客户,但文件在磁盘上通常只能放在一个位置。标签则允许同一份记忆拥有多个入口,同时不改变文件原本的目录结构。
一份记忆,先说清楚“关于谁或什么”
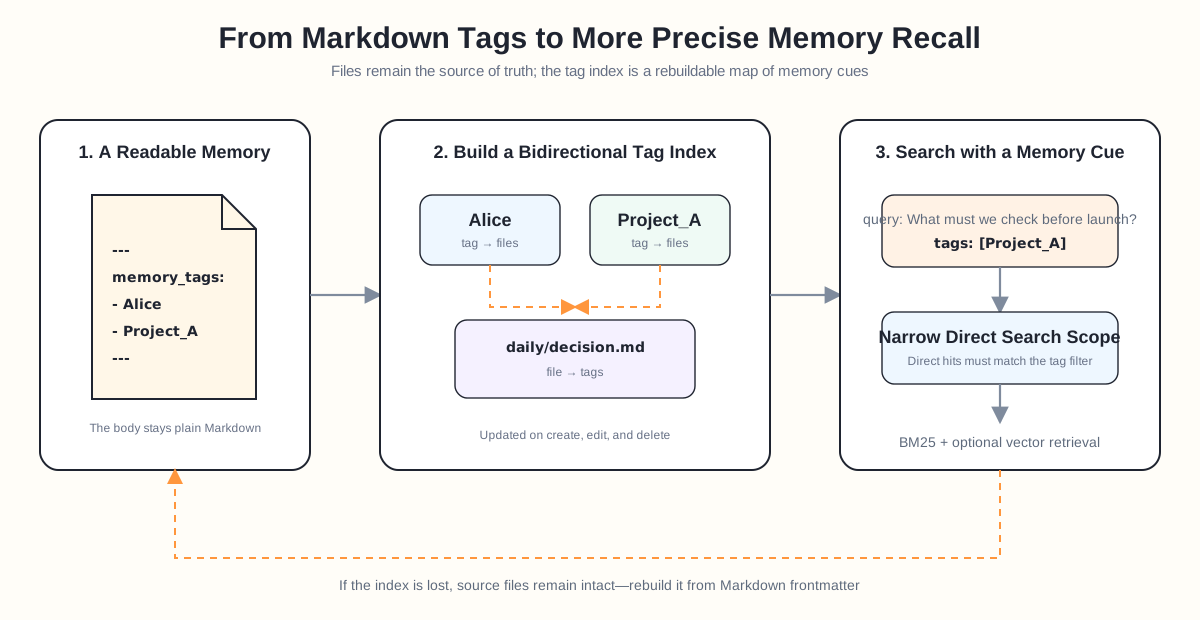
ReMe 的记忆仍然是普通 Markdown。标签直接写在文件的 YAML frontmatter 中,例如:
---
name: Project A 发布前检查
description: Alice 确认了发布窗口、回滚条件和客户通知顺序。
memory_tags:
  - Alice
  - Project_A
---

Project A 定于周四晚发布。发布前需要先完成回归测试,并由 Alice
确认客户通知;如果错误率超过约定阈值,则执行回滚。
默认字段名是 memory_tags。这个名字有意强调:它不是给文章随手贴一串宽泛关键词,而是在回答一个更稳定的问题:
这份 Markdown 承载的是关于谁或什么现实实体的记忆?
这里的实体可以是人物、组织、公司、项目或资产,例如 Alice、宁德时代、Project_A、黄金。相比“工作”“重要”“会议”这类宽泛主题,实体更适合作为长期记忆的锚点,因为人、组织和项目往往会跨越许多次对话持续出现。
在默认配置中,Auto Memory(auto_memory、auto_memory_cc)和 Auto Dream(auto_dream、dream_cron)会为本轮实际新增或修改的 daily、digest Markdown 生成这类标签。打标时,它会先阅读完整文档和现有 frontmatter,再查看工作区已经使用的标签,优先复用同一个实体的已有写法,避免 Project_A、project a 和 项目A 在不知不觉中变成三套标签。手动导入或编辑文件不会触发自动打标;文件里已经存在的 memory_tags 则会由文件监听流程同步到 Tag Index。
默认情况下,一份文件只选择最主要的实体;确实围绕多个独立实体时才使用多个标签,并限制标签数量。没有明确核心实体的文档也可以使用空列表:
memory_tags: []这比“为了打标签而打标签”更重要。标签越多不代表记忆越丰富;太多宽泛标签反而会让每次过滤都重新变成全库搜索。
当然,memory_tags 只是 ReMe 的默认约定。标签索引读取哪个 frontmatter 字段可以配置,标签值也由用户自己的工作区决定。已经有 entities、people 或其他字段规范的团队,可以让索引适配自己的文件,而不必把 Markdown 迁入另一套封闭格式。
Tag Index 怎么工作?
读取到 frontmatter 后,ReMe 会构建两张很简单的“线索表”:“一个标签对应哪些文件”,以及“一份文件有哪些标签”。例如:
Alice       -> daily/project-a-launch.md
Project_A   -> daily/project-a-launch.md

daily/project-a-launch.md -> Alice, Project_A
这是一份基于 Markdown 文件派生出来的双向索引。新增或修改记忆时,对应关系会更新;文件删除后,旧关系也会被移除。标签在比较时会忽略大小写,并统一空格等形式,减少同一标签因为书写差异而分裂。
索引本身不取代文件,也不是新的事实来源。真正的标签仍然写在用户可见、可编辑的 frontmatter 里。即使索引丢失,也可以从当前文件图中的 Markdown 元数据重新构建:
reme reindex scope=tag这仍然遵循 ReMe 一贯的原则:文件属于用户,索引服务于文件,并且随时可以重建。
如果想看看当前工作区里有哪些标签,以及每个标签关联了多少文件,可以直接列出标签:
reme list_tags order_by=file_count order=desc它不仅方便搜索,也让记忆库的结构变得可观察。你可以很快发现某个项目已经积累了大量记忆,也可以发现同一个人是否被误写成了几种近似名称。
搜索时,标签如何参与?
Memory Tags 最重要的作用不是展示,而是过滤。
还是前面的例子。只搜索一句自然语言:
reme search query="发布前还有什么要确认?"这是在整个可搜索记忆范围内寻找答案。加入标签后:
reme search \
  query="发布前还有什么要确认?" \
  tags='["Project_A"]'
ReMe 会先通过 Tag Index 找出带有 Project_A 的文件,再让 BM25 和可选向量检索只从这些文件中产生直接命中,最后照常完成排名融合。
这里有一个边界:标签过滤约束的是直接检索命中,不会截断 Wikilink 关系。默认的链接展开仍可能列出标签范围外邻居的路径、名称和描述,帮助 Agent 判断是否要继续读取;这些邻居不会因此变成关键词或向量检索的直接命中。
这可以概括为:
自然语言问题 + 标签线索
          ↓
Tag Index 找到候选文件
          ↓
在候选文件中做关键词 / 语义检索
          ↓
返回直接命中片段,并按需列出关系
(关系邻居可能在标签范围之外)
标签过滤还可以和日期条件叠加。例如,只查看某个项目在最近一个月形成的记忆。每个条件都负责缩小一个维度:实体限定“关于谁或什么”,日期限定“什么时候”,搜索词限定“具体想知道什么”。
如果一次提供多个标签,ReMe 当前采用“命中任意一个即可”的方式筛选文件。比如 tags=[Alice, Project_A] 会召回关于 Alice 或 Project A 的记忆,再由搜索词决定哪些内容排在前面。这种方式适合 Agent 用几个可能的实体线索扩大候选集,同时避免回到全库搜索。
它会带来什么变化?
Memory Tags 带来的效果,不是让每次搜索都多一个必填参数。没有标签时,原有搜索仍然可以正常工作。它真正改变的是:当用户或 Agent 已经知道一部分上下文时,这些上下文不再只能藏在一句模糊的查询里。
1. 同一句话,不再轻易串到别的项目
“上次为什么延期”“预算是谁确认的”“发布前还差什么”都是高度依赖上下文的问题。标签先把项目或人物范围固定下来,可以减少名字相似、内容相似的其他记忆进入候选集。
2. 围绕同一实体的记忆可以跨时间聚合
Alice 可能出现在会议记录、项目决策、个人偏好和复盘文档中。这些文件不需要被搬到同一个目录,只要共享同一标签,就可以形成一个跨目录、跨日期的实体视图。
3. 记忆的结构对人和 Agent 都可见
标签不是藏在专用数据库里的内部字段。用户打开 Markdown 就能看到、修改和审阅它。Agent 也可以先查看当前有哪些标签,再决定带着哪个实体线索搜索。错误标签能被发现,标签命名也能逐步收敛。
4. 搜索更容易解释
当结果不符合预期时,可以把问题拆开检查:文档是否写对了 memory_tags,Tag Index 是否包含对应路径,还是关键词或语义排名没有命中。相比一个无法观察的整体分数,这条链路更容易诊断和修正。
Tags 不是分类法,而是记忆的提取线索
我们并不希望把个人知识库变成一棵需要精心维护的分类树。真实记忆天然会重叠:一次谈话既可能关于一个人,也可能关于一个项目;一项决定既属于当下的会议,也会影响几个月后的复盘。
Memory Tags 更像人类记忆里的提取线索。看到一个人的名字,我们会想起共同经历;想到一个项目,我们会联想到相关决定、问题和承诺。线索本身不是记忆正文,却能帮助我们从大量经历中更快进入正确的上下文。
ReMe 所做的事情很朴素:
- 用 Markdown 保存完整、可读的记忆;
- 用
memory_tags表达“这份记忆关于谁或什么”; - 用可重建的 Tag Index 把实体和文件连接起来;
- 搜索时先用标签缩小范围,再用关键词、语义和链接找到具体答案。
这样,记忆不只是一堆可以全文搜索的文档,也开始拥有更符合人类联想方式的结构。
当你说“还是上次 Alice 那个项目”时,Agent 获得的不再只是一句话。它有了一条可以真正沿着走回过去的线索。